Cambios pequeños, gran impacto: aprendizajes optimizando una plataforma de datos
Cómo algunos cambios puntuales mejoraron la latencia, los costos y la confiabilidad de una plataforma de datos.
En este artículo
Introducción
El año pasado me sumé a un equipo responsable de una plataforma de datos madura, con varias herramientas y productos de datos que ya estaban corriendo en producción. Desde el primer día, el stack era fácil de entender: cada capa tenía una herramienta dedicada y una responsabilidad clara. Ingesta de datos, transformaciones con dbt, orquestación con Airflow y Metabase para analytics y reporting.
Esta separación de responsabilidades hizo que entender la arquitectura fuera mucho más sencillo, sin perderme en detalles innecesarios durante el onboarding.
En general, la plataforma funcionaba bien, pero rápidamente noté algunos problemas que no dejaban de hacerme ruido:
- Una cantidad importante de DAGs de Airflow incumplía sus SLAs de manera constante. Por la cadena de dependencias entre DAGs, una falla o demora en un workflow upstream podía afectar a varios workflows downstream, incluso cuando la dependencia no era estrictamente necesaria. Lo mismo ocurría con el monitoreo de SLAs: un DAG demorado podía hacer que sus DAGs dependientes incumplieran sus SLAs, sin importar el estado real del proceso upstream.
- Queries analíticas que tardaban hasta dos minutos. Incluso dashboards sencillos de Metabase necesitaban bastante tiempo para refrescar después de aplicar un filtro.
- Un consumo creciente de créditos de Snowflake. El uso aumentaba mes a mes sin una explicación clara, lo que hacía difícil justificar los costos de infraestructura.
Una mejora a la vez
Lo primero que hice fue poner todos estos problemas sobre la mesa. Ver el panorama completo me ayuda a priorizar el trabajo según el impacto general, en lugar de tratar cada problema por separado.
Por ejemplo, el consumo de créditos de Snowflake probablemente era el tema más urgente desde el lado del presupuesto. Sin embargo, si los datos no llegan al warehouse porque los SLAs incumplidos rompen las cadenas de DAGs, el freshness se demora varias horas y los dashboards tardan minutos en cargar, el problema deja de ser sólo deuda técnica y pasa a ser un dolor para toda la organización.
Con ese contexto, la primera prioridad estaba clara: mejorar la confiabilidad de nuestros pipelines de Airflow y reducir la fricción operativa antes de encarar optimizaciones en otros lugares.
Una línea, tres veces más rápido
Esta función auxiliar define una tarea de un DAG que depende de una tarea de otro DAG:
def externalDependency(dag, ext_dag, task_id, timeout=5400):
    return ExternalTaskSensor(
        dag=dag,
        task_id="ext_{}".format(task_id),
        external_dag_id=ext_dag,
        external_task_id=task_id,
        timeout=timeout,
        mode="poke",
        poke_interval=60,
        execution_timeout=timedelta(seconds=timeout)
    )
Esta era una de las dependencias centrales de un DAG que habilitaba gran parte del grafo de modelos de dbt utilizado por nuestras cargas analíticas.
A primera vista, todo parecía estar bien. Sin embargo, mientras investigaba los problemas de SLA, noté que muchas tareas pasaban una cantidad inusual de tiempo en la cola, esperando un worker disponible. Al revisar más en detalle los patrones de ejecución, vi que una parte importante de los workers estaba ocupada por sensores que simplemente esperaban a que terminaran los DAGs upstream.
El verdadero problema estaba escondido en un único parámetro de configuración: mode="poke".
Cuando un ExternalTaskSensor corre en modo poke, ocupa continuamente un slot de worker mientras verifica si la tarea objetivo alcanzó el estado esperado. Si el timeout está configurado en una hora, ese worker queda ocupado hasta una hora, despertándose cada tanto para hacer la verificación.
Para ponerlo en perspectiva, imaginemos que hay 10 workers disponibles y 11 tareas esperando para correr. Una de ellas va a tener que esperar simplemente porque todos los slots están ocupados, aunque algunos sólo estén esperando una condición externa.
En muchos entornos esto quizás no sea un problema importante. Sin embargo, cuando un DAG crítico habilita decenas de DAGs downstream, la saturación de workers puede convertirse rápidamente en un cuello de botella, especialmente si se combina con SLAs estrictos.
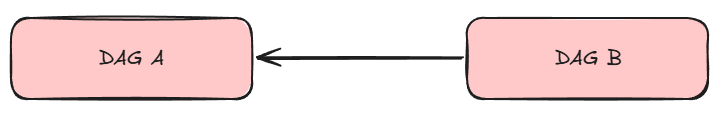
Si el DAG A falla, el DAG B también va a fallar o directamente nunca va a dispararse. A medida que se agregan dependencias al grafo, el data warehouse puede pasar horas sin recibir datos frescos.
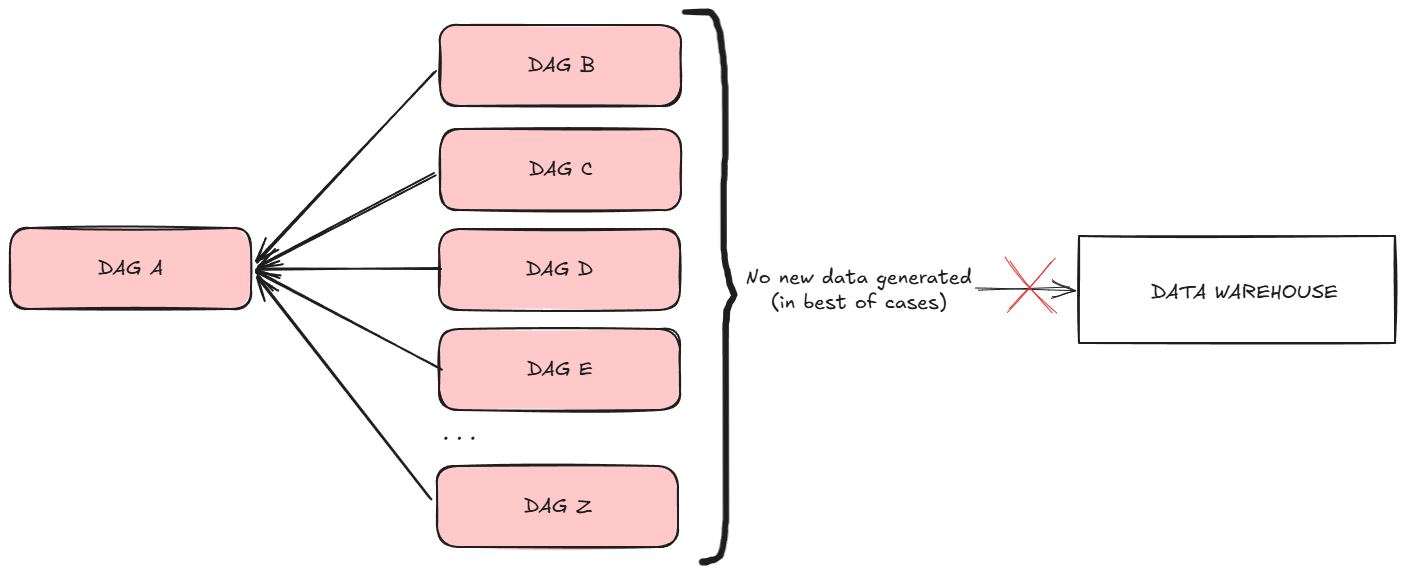
En el mejor de los casos, alguien arregla el DAG A, limpia la cadena de dependencias y todo vuelve a funcionar normalmente. La contra es que para entonces ya perdiste horas de freshness y tiempo operativo.
Para mitigar esto, cambié una sola línea:
def externalDependency(dag, ext_dag, task_id, timeout=5400):
    return ExternalTaskSensor(
        dag=dag,
        task_id="ext_{}".format(task_id),
        external_dag_id=ext_dag,
        external_task_id=task_id,
        timeout=timeout,
        mode="reschedule",
        poke_interval=60,
        execution_timeout=timedelta(seconds=timeout)
    )
A primera vista, el modo reschedule se parece mucho a poke, pero el comportamiento es completamente distinto.
Mientras poke mantiene ocupado al worker durante todo el período de espera, reschedule lo libera después de cada verificación y se programa para volver a ejecutarse más tarde. Mientras tanto, otras tareas y DAGs pueden usar ese slot.
En la práctica, esto significa que las demoras o problemas temporales en workflows upstream ya no bloquean todo el entorno de ejecución.
El impacto fue inmediato:
- El tiempo de ejecución del grafo completo de DAGs bajó de hasta 3 horas a, normalmente, entre 30 y 45 minutos.
- La latencia end-to-end de los datos se redujo de aproximadamente 2 horas a menos de 45 minutos.
La verdadera ganancia no fue reducir el tiempo de ejecución, sino recuperar un freshness predecible para toda la organización.
Cuando los equipos analíticos saben cuándo van a llegar los datos, los dashboards se vuelven más confiables, el troubleshooting es más sencillo y mejora la confianza operativa en la plataforma.
En definitiva, estas mejoras hicieron que los datos frescos llegaran mucho más rápido al warehouse.
También había otras opciones. Por ejemplo, crear Airflow Pools dedicados y asignar distintos valores de priority_weight podía ayudar a priorizar las cargas críticas. Aumentar el paralelismo o sumar workers también era posible, pero en nuestro caso el objetivo no era escalar la infraestructura.
Hoy, probablemente elegiría primero los operadores diferibles, ya que consiguen un resultado similar de forma más eficiente al delegar las tareas en espera al proceso Triggerer.
Lamentablemente, nuestra versión de Airflow era demasiado vieja para soportarlos y actualizar la plataforma era un proyecto bastante más grande por sí mismo.
Dos pájaros de un tiro: reducir el tiempo de las queries y los costos de Snowflake
Ahora que los datos llegaban al warehouse a tiempo, era momento de encarar el siguiente desafío:
- ¿Por qué dashboards aparentemente sencillos tardaban tanto en refrescar?
- ¿Por qué el consumo de créditos de Snowflake crecía mes a mes?
Al final, ambos problemas compartían la misma causa.
Varios de nuestros modelos más importantes, consumidos por dashboards y transformaciones downstream en toda la organización, estaban materializados como views.
Al principio tenía sentido. Estos modelos estaban en el centro del grafo de dependencias y los cambios en los datos upstream podían afectar el resultado final. Las views garantizaban que cada query siempre devolviera la última versión de los datos.
La contra era que cada query de un dashboard volvía a ejecutar el cálculo de la view.
Una vez.
Y otra.
Y otra.
A medida que se agregaban joins, columnas y dependencias upstream, ejecutar estas views se volvía cada vez más costoso. Cada pregunta de Metabase pagaba el costo completo de reconstruir una parte importante del grafo de transformaciones antes de devolver un resultado.
El impacto aparecía en dos lugares:
- Queries de dashboards que tardaban varios minutos.
- Un consumo de créditos de Snowflake que aumentaba de forma sostenida mes a mes.
Mi solución no fue particularmente sofisticada, pero sí muy efectiva.
Primero, cambié la estrategia de materialización de los modelos centrales de view a table.
Esto permitió que las queries analíticas leyeran datos precalculados en vez de volver a ejecutar las mismas transformaciones cada vez que alguien abría un dashboard o aplicaba un filtro.
La preocupación obvia era el freshness de los datos.
Para resolverlo, agregué un DAG de Airflow cuya única responsabilidad era mantener actualizados estos modelos centrales con una frecuencia alta.
Esto introdujo una pequeña demora en el freshness, por lo general de no más de 5 a 10 minutos, pero era un trade-off con el que estábamos cómodos considerando los resultados:
- Una reducción de hasta el 44% en el consumo mensual de créditos de Snowflake.
- El tiempo promedio de ejecución de queries bajó de varios minutos a menos de 10 segundos.
- Una reducción aproximada del 95% en la latencia p95 de las queries.
- Dashboards que refrescaban más rápido y una experiencia mucho mejor en Metabase.
Lo más importante es que resolvimos ambos problemas con el mismo cambio.
Las queries pasaron a ser muchísimo más rápidas y Snowflake dejó de gastar créditos recalculando la misma lógica para cada consulta de un dashboard.
Dependiendo del contrato de Snowflake y del tamaño de las cargas, mejoras como estas pueden traducirse fácilmente en miles de dólares de ahorro por mes.
Reflexiones finales
Seguramente existan mejores soluciones y enfoques más sofisticados para los desafíos que describí.
El objetivo de este post no era presentar un trabajo de ingeniería revolucionario, sino recordar que a veces las mejoras de mayor impacto vienen de entender el problema en profundidad, y no de sumar tecnología nueva.
En este caso, unos pocos cambios relativamente chicos ayudaron a reducir la carga operativa, mejorar el freshness, bajar los costos de infraestructura y ofrecer una experiencia mucho mejor para quienes consumían los datos.
Sobre todo, permitieron que el equipo pasara menos tiempo peleando con problemas recurrentes y más tiempo construyendo cosas nuevas.
Por ejemplo, una de las próximas iniciativas de mi lista era construir infraestructura para aplicaciones impulsadas por IA. Pero esa es una historia para otro post.
¿Qué sigue?
Lamentablemente, esa etapa terminó después de una reestructuración general de la empresa a principios de este mes.
Aun así, trabajar en problemas como estos reforzó lo que más disfruto: entender cómo se comportan los sistemas, identificar cuellos de botella y encontrar soluciones pragmáticas que generen un impacto medible.
Actualmente estoy buscando mi próxima oportunidad en Data Engineering, Analytics Engineering o roles relacionados con plataformas.
Me gusta trabajar a lo largo de todo el ciclo de vida de los productos de datos, desde infraestructura y orquestación hasta modelado, optimización de rendimiento y mejores decisiones a partir de los datos.
Si este artículo te resultó familiar, o si estás trabajando en desafíos parecidos, escribime. Siempre está bueno conectar e intercambiar ideas.
Traducción del artículo publicado originalmente en DEV Community.